
Tóm tắt nhanh
Jev là gì? Jev là mô hình đầu tiên của lớp System One Models do TypeSafe AI (San Francisco) phát hành dạng early access năm 2026. Đầu vào: state (văn bản/JSON). Đầu ra: quyết định có kiểu (noul, choice, score) kèm phân phối xác suất và confidence. Không sinh văn bản, không giải thích, không viết code. Mục tiêu: trở thành “lời gọi hàm trí tuệ cấp frontier” — rẻ hơn, nhanh hơn LLM hàng chục đến hàng trăm lần trên đúng loại tác vụ phán đoán nhanh (theo tuyên bố của công ty).
1. Câu hỏi khởi nguồn: “Tự động hoá ở đâu?”
Bài giới thiệu chính thức của TypeSafe mở đầu bằng câu hỏi: “Models have been superhuman at chat for years, so where is all the automation?” — mô hình đã siêu phàm về hội thoại nhiều năm, vậy tự động hoá ở đâu?
Chẩn đoán của TypeSafe gồm bốn mắt xích:
- Đầu ra sai hình dạng. LLM trả về chuỗi tự do; phần mềm cần giá trị có kiểu (bool, enum, số). Khoảng cách được lấp bằng parse + validate + retry → chậm, đắt, dễ vỡ.
- Mục tiêu huấn luyện sai. RLHF tối ưu cho sở thích con người (văn phong, sự hữu ích cảm nhận), RLVR tối ưu cho bài toán kiểm chứng được (toán, code, benchmark). Không cái nào tối ưu trực tiếp cho xác suất quyết định chính xác. Hệ quả nêu trong tài liệu: mode dropping (phân phối đầu ra co hẹp về kiểu ưa thích), quá tự tin, thiếu nhất quán.
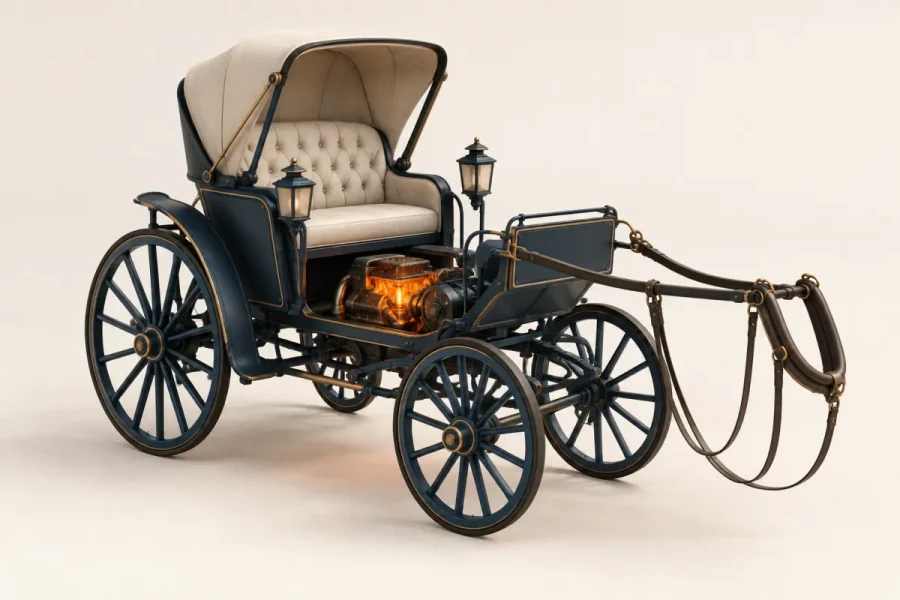
- Hình dạng “trợ lý” giả định có người trong vòng lặp. Manifesto gọi đây là vấn đề “xe ngựa không ngựa” (horseless carriage): ô tô đời đầu sao chép hình dạng xe ngựa; AI hiện tại sao chép hình dạng người trợ lý.
- Trí tuệ khó xây chồng lên. Manifesto: “today’s intelligence is hard to build on” — AI hôm nay giống cơ sở dữ liệu trước khi có SQL: mỗi lần dùng là một lần làm thủ công.
Kết luận của TypeSafe: nút thắt không phải mức độ thông minh mà là hình dạng của trí tuệ. Khẩu hiệu manifesto: “Composable AI: Build Prod, Not God” — xây hệ thống sản xuất, đừng xây thần thánh (AGI).
2. Jev là gì: định nghĩa vận hành
| Khía cạnh | System One Model (Jev) | LLM / System Two (Claude, GPT, Codex…) |
|---|---|---|
| Đầu vào | State phi cấu trúc (chuỗi, JSON, mảng) + câu hỏi có kiểu | Chuỗi tin nhắn hội thoại |
| Đầu ra | Giá trị có kiểu + phân phối xác suất + confidence | Chuỗi token tự do |
| Lấy mẫu | “Sampler song song” — mọi đầu ra trong một truy vấn (tuyên bố) | Tuần tự, từng token |
| Huấn luyện | RLCD — tối ưu xác suất hiệu chỉnh | Pretrain + SFT + RLHF/RLVR |
| Lỗi kiểu | 0% “theo cấu trúc” (schema bảo đảm) | Có thể sai JSON, sai enum |
| Ảo giác | Không có “ảo giác văn bản”; vẫn có thể sai quyết định | Có |
| Độ trễ | 70–500 ms end-to-end (tuyên bố); ~100 ms điển hình (docs) | Vài giây đến hàng trăm giây với mô hình suy luận |
| Giá | $0,042/1M token vào; đầu ra $0 | Đầu vào và đầu ra đều tính phí; đầu ra thường đắt hơn nhiều lần |
| Giải thích | Không | Có (chuỗi suy luận) |
| Thế mạnh | Phân loại, định tuyến, chấm điểm, xác minh, guardrail, map-reduce dữ liệu lớn, thời gian thực | Sinh nội dung, code, suy luận nhiều bước, tác tử có người giám sát |
Lưu ý thuật ngữ quan trọng: “Không ảo giác” ở đây nghĩa là không bịa ra chuỗi ngoài tập trả lời hợp lệ. Jev vẫn có thể chọn sai phương án — chỉ là sai trong khuôn khổ kiểu và kèm xác suất cho biết mức chắc chắn. TypeSafe tự ghi chú rằng con số 0% lỗi kiểu “không phải thực nghiệm” mà do khớp schema được bảo đảm.
Từ dữ liệu tới quyết định: hai con đường
LLM / System Two
- Chuỗi tin nhắn hội thoại
- Sinh token tuần tự
- Chuỗi văn bản tự do
- Parse, validate, retry
- Giá trị để phần mềm dùng
Vài giây đến hàng trăm giây · tính phí cả đầu vào lẫn đầu ra · có thể sai JSON, sai enum
Jev / System One
- State + câu hỏi có kiểu
- Đánh giá song song mọi câu hỏi
- Giá trị có kiểu + xác suất + confidence
- Code rẽ nhánh theo ngưỡng
70–500 ms (tuyên bố) · $0,042/1M token vào, đầu ra $0 · schema bảo đảm, vẫn có thể sai quyết định
3. Ba nguyên thủy — “bảng chữ cái” của System One
| Nguyên thủy | Câu hỏi | Ràng buộc | Trả về |
|---|---|---|---|
noul |
Mệnh đề này đúng không? | Nhị phân; tuỳ chọn mô tả true/false |
Số 0–1 = P(đúng) |
choice |
Phương án nào áp dụng? | 2–255 phương án, mỗi phương án có mô tả | choice, probabilities, confidence |
score |
Nằm ở đâu trên thang thứ bậc? | 2–10 mức mô tả, đánh số theo vị trí từ 0 | score (kỳ vọng, có thể lẻ), probabilities, confidence, legend |
Mọi câu hỏi trong một request được đánh giá song song và cô lập trên cùng một state: thêm câu hỏi hầu như không tăng độ trễ, và không có “context rot” giữa các câu hỏi. Chi tiết thiết kế ở Bài 3.
4. Nguồn gốc tên gọi và triết lý
- “System One”: từ Thinking, Fast and Slow (Daniel Kahneman). Hệ 1 = nhanh, trực giác, tự động; Hệ 2 = chậm, có chủ đích. Jev đảm nhận phán đoán nhanh, tập trung; suy luận dài để lại cho LLM.
- “Jev”: đặt theo William Stanley Jevons — nhà kinh tế học thế kỷ 19 với nghịch lý Jevons: máy hơi nước hiệu quả hơn khiến tổng tiêu thụ than tăng chứ không giảm. TypeSafe đặt cược trí tuệ máy sẽ đi theo đúng quỹ đạo đó: khi chi phí một quyết định thông minh gần bằng 0, nhu cầu bùng nổ — mọi
iftrong phần mềm đều có thể “rẽ nhánh theo ngữ nghĩa”. - “Smart if-statements”: chú thích đùa trong manifesto, nhưng là định nghĩa sản phẩm chính xác nhất: code được phép “branch on common sense, understanding, and intent” — rẽ nhánh theo lẽ thường, sự hiểu và ý định, không chỉ theo bit.
- Hướng neuro-symbolic: mạng nơ-ron lo tri giác ngữ nghĩa; logic ký hiệu (code) lo tính toán chính xác và luồng điều khiển.
5. TypeSafe AI: tổ chức đứng sau
| Hạng mục | Thông tin (theo nguồn TypeSafe) |
|---|---|
| Trụ sở | San Francisco (“Made in SF”) |
| Nhà sáng lập | Diogo Almeida — tự giới thiệu từng xây dựng các phương pháp tại OpenAI trở thành nền tảng nghiên cứu cho ChatGPT |
| Giai đoạn | Ra mắt sau “hai năm hoạt động bí mật” (stealth) |
| Sản phẩm | Jev (early access, có waitlist), API console, Playground, SDK Python & JavaScript, agent skill |
| Vốn | $870 triệu, định giá $7,5 tỷ; a16z dẫn dắt, Sequoia Capital, DCVC; Martin Casado vào HĐQT. Trang công bố ghi lẫn “Series AI”/”series A” |
| Khách hàng tuyên bố | “Một phần ba Fortune 500”; case study công khai: Jack & Jill (tuyển dụng) |
| Mục tiêu kinh tế (manifesto) | Tăng trưởng năng suất nhân tố tổng hợp (TFP) toàn cầu đạt 3% trong 5 năm và duy trì 10 năm |
Luận đề “Bitterest Lesson” (blog TypeSafe) — mở rộng “Bitter Lesson” của Rich Sutton. Thứ tự quan trọng trong ML: (1) làm đúng tác vụ → (2) dữ liệu → (3) compute → (4) thuật toán. Ví dụ: InstructGPT — mô hình cỡ GPT-2 (nhỏ hơn GPT-3 >100 lần) nhưng huấn luyện đúng tác vụ đã thắng GPT-3. Ngụ ý cho Jev: mô hình không cần lớn nhất, chỉ cần tối ưu đúng tác vụ quyết định hiệu chỉnh.
Luận đề chống “benchmaxxing” (blog “Lies, Damned Lies, and Benchmarks”): TypeSafe không công bố bảng benchmark chuẩn; cam kết eval mới dạng ảnh chụp có ngày, nghỉ hưu sau khi công bố, đăng kèm kết quả bất lợi. Đây vừa là lập trường phương pháp luận, vừa khiến cộng đồng phải tự đo (xem Bài 4).
6. Tuyên bố hiệu năng chính (của công ty)
| Chỉ số | Giá trị công bố | Ghi chú phương pháp |
|---|---|---|
| Tốc độ so với LLM trên workflow System One | 193,6× nhanh hơn | Đáp án tham chiếu = trung bình GPT-6 Astra & Fable 5.1 |
| Chi phí | 444,6× rẻ hơn | Như trên |
| Ví dụ đối chiếu | Jev $0,000081 / 0,114 s vs LLM $0,013880 / 8,566 s | Một truy vấn minh hoạ |
| Giá đầu vào | $42/1 tỷ token; “238× thấp hơn Claude Fable 5.1” | Đầu ra miễn phí |
| Độ trễ | 70–500 ms; LLM frontier 3–329 s | Đo từ laptop Bờ Tây Mỹ |
| Demo Doom | ~10 truy vấn/giây, ~$7/giờ | Jev điều khiển game qua quyết định |
| Wikiracing | Cardinality tới 255; vượt ngưỡng dùng 2 tầng score→choice | So với LLM ở chế độ không suy luận |
Tự thừa nhận hạn chế (rất hiếm ở thông cáo sản phẩm, đáng ghi nhận về mặt học thuật): giá có thể đang được trợ cấp; workflow do chính đội TypeSafe xây (có thể thiên lệch); LLM chạy qua lớp bọc System One của TypeSafe nên có thể chậm/đắt hơn thực tế; so sánh wikiracing dùng LLM không bật suy luận.
7. Định vị trong bức tranh AI 2026
Có thể xếp các công cụ “quyết định trên văn bản” theo hai trục: độ tổng quát và chi phí/độ trễ:
| Lớp công cụ | Ví dụ | Tổng quát | Chi phí/độ trễ | Xác suất dùng được |
|---|---|---|---|---|
| Luật/regex | Biểu thức chính quy, rule engine | Thấp | ~0 | Không |
| Classifier chuyên biệt | BERT/DeBERTa fine-tune, zero-shot NLI | Thấp–trung bình | Rất thấp | Có, nhưng cần huấn luyện/hiệu chỉnh |
| Embedding + kNN/reranker | bge, gte, cross-encoder | Trung bình | Thấp | Gián tiếp (độ tương đồng) |
| System One (Jev) | Jev 1.13, bản mở JEV-27B, Open-Jev | Cao (zero-shot, rubric tự định nghĩa) | Thấp | Có, hiệu chỉnh là mục tiêu huấn luyện |
| LLM structured output | Claude/GPT với JSON schema | Rất cao | Cao | Yếu (xác suất “nói ra” kém hiệu chỉnh) |
| LLM suy luận / tác tử | Claude Code, Codex | Rất cao + hành động | Rất cao | Không trực tiếp |
Điểm mới thực sự không nằm ở từng thành phần (zero-shot classification, logprob, calibration đều đã có), mà ở đóng gói: (a) rubric tự định nghĩa bằng ngôn ngữ tự nhiên, (b) tới 255 phương án, (c) xác suất được tối ưu hiệu chỉnh, (d) song song nhiều câu hỏi, (e) giá và độ trễ ở mức “gọi hàm”. Một phân tích độc lập (Decision Models Under Pressure) nhận định ý tưởng có trước Jev, nhưng Jev là bản hiện thực mạnh nhất trong nhóm được đo — một kết luận cân bằng đáng giữ lại.
8. Những gì Jev không làm (để tránh kỳ vọng sai)
- Không sinh văn bản, không tóm tắt, không dịch, không viết code, không giải thích lý do.
- Không xử lý ảnh/âm thanh/video (bản hosted 1.13 chỉ nhận văn bản; một số bản mở cộng đồng có biến thể VL).
- Không phải máy tính: kém đếm, số học, so sánh ngày tháng (xem “jaggedness”, Bài 4).
- Không tự coi state là thù địch: dễ bị prompt injection nếu không thiết kế tiêu chí rõ.
- Huấn luyện chủ yếu tiếng Anh; ngôn ngữ khác (TypeSafe nêu ví dụ CJK) có độ chính xác thấp hơn — đặc biệt quan trọng với nội dung tiếng Việt.
- Context: tổng state + mọi câu hỏi ≤ 64k token; state + câu hỏi dài nhất ≤ 32k token.
9. Mô hình tư duy để ghi nhớ
LLM là nhân viên biết viết; Jev là cảm biến biết hiểu. Cảm biến không viết báo cáo — nó đo, trả số, và để hệ thống điều khiển quyết định hành động theo ngưỡng.
Ba hệ quả thiết kế:
- Code giữ quyền điều khiển — Jev không chọn bước tiếp theo như một tác tử; nó trả lời câu hỏi hẹp, code quyết định luồng.
- Phân rã thay vì hỏi rộng — “Đây có phải spam?” → 5 câu hỏi nguyên tử (đòi thông tin đăng nhập? hứa thưởng bất ngờ? áp lực thời gian? người gửi không khớp? liên kết lừa?), kết hợp có trọng số trong code.
- Xác suất là giao diện an toàn — ngưỡng theo mức rủi ro: đọc số dư có thể tự động ở confidence 0,5; chuyển tiền đòi > 0,9 (ví dụ trong tài liệu).
10. Câu hỏi mở cho nghiên cứu
- Kiến trúc thật của Jev? (encoder hai chiều chấm từng phương án? decoder với head quyết định? — chưa công bố). Hành vi thiên vị phương án đầu và phụ thuộc thứ tự (Bài 4) gợi ý mô hình đọc danh sách phương án như một tập có thứ tự, không chấm độc lập từng phương án.
- RLCD khác gì về toán học so với tối ưu quy tắc chấm điểm thích đáng (proper scoring rules) như log-loss/Brier? (Bài 2.)
- Giá $0,042/1M có bền vững? TypeSafe thừa nhận có thể đang trợ cấp.
- Lớp “System One” sẽ thành chuẩn ngành (như embedding API) hay bị LLM nuốt lại qua logprob + hiệu chỉnh hậu kỳ?
Câu hỏi thường gặp
Jev là gì?
Jev là mô hình AI đầu tiên thuộc lớp “System One Model” của TypeSafe AI. Nó nhận dữ liệu dạng văn bản cùng các câu hỏi có kiểu (có/không, chọn một phương án, chấm mức), rồi trả về quyết định kèm xác suất trong khoảng 0,1–0,5 giây. Jev không sinh văn bản.
Jev khác ChatGPT, Claude thế nào?
ChatGPT và Claude sinh văn bản, viết code và suy luận nhiều bước. Jev chỉ đưa ra quyết định có kiểu kèm xác suất, nhanh và rẻ hơn nhiều lần trên đúng loại việc phân loại, định tuyến, chấm điểm. Hai loại bổ sung cho nhau, không thay thế nhau.
Giá Jev bao nhiêu?
Theo tài liệu TypeSafe (10/2026): $0,042 cho 1 triệu token đầu vào, đầu ra miễn phí. TypeSafe thừa nhận mức giá này có thể đang được trợ giá.
Tên Jev có nghĩa gì?
Jev được đặt theo nhà kinh tế học William Stanley Jevons, tác giả “nghịch lý Jevons”: khi một nguồn lực rẻ và hiệu quả hơn, tổng nhu cầu dùng nó lại tăng.
Đọc tiếp trong chuỗi
Nguồn tham khảo
- TypeSafe AI — Trang chủ: https://typesafe.ai
- Introducing System One Models & Jev: https://typesafe.ai/blog/introducing-system-one-models-and-jev
- Manifesto “Composable AI: Build Prod, Not God”: https://typesafe.ai/manifesto
- The Bitterest Lesson: https://typesafe.ai/blog/bitterest-lesson
- Lies, Damned Lies, and Benchmarks: https://typesafe.ai/blog/antibenchmaxxing
- TypeSafe A raises Series AI: https://typesafe.ai/blog/series-ai
- Docs — Introduction: https://docs.typesafe.ai/introduction ; System One: https://docs.typesafe.ai/concepts/system-one ; Models: https://docs.typesafe.ai/models
- Decision Models Under Pressure (gazelle93): https://github.com/gazelle93/decision-models-under-pressure
